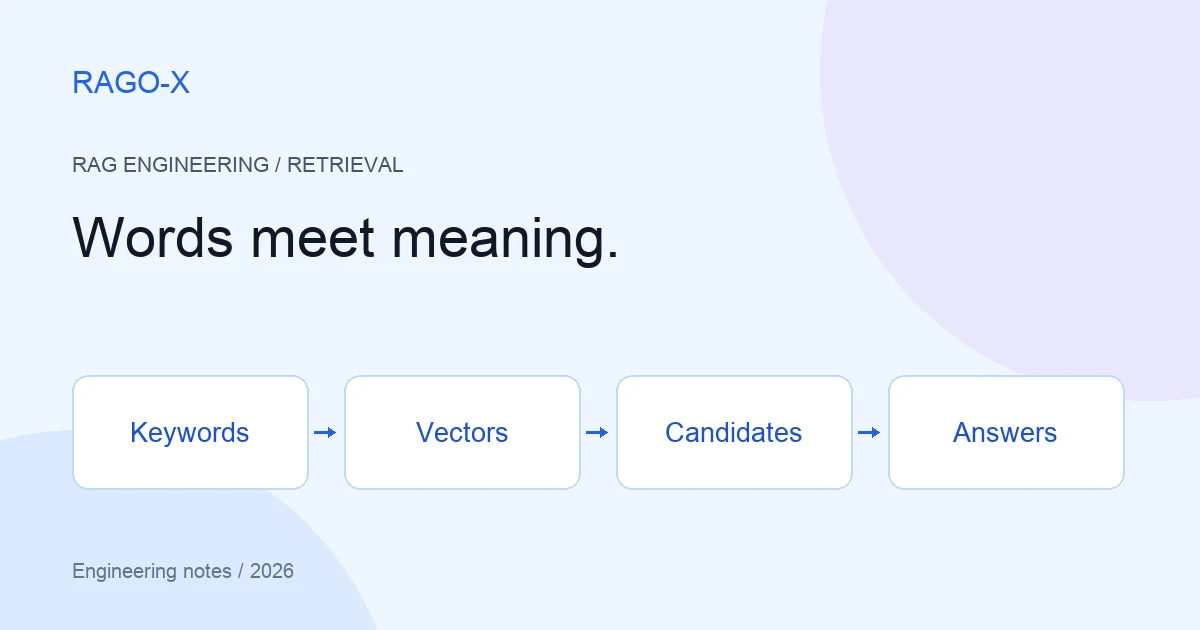
„X17 Filterwechsel“ und „Was prüfe ich bei sinkendem Ansaugdruck?“ können dasselbe Handbuch benötigen. Die erste Frage erfordert einen exakten Code, die zweite ein Verständnis anderer Formulierungen. Hybride Suche führt Kandidaten mehrerer Suchverfahren zusammen.
Die Anleitung verwendet Python 3 ohne Zusatzpakete. Fragen und Ranglisten sind fiktive Übungsdaten, keine produktiven RAGO-X-Einstellungen oder gemessenen Leistungswerte.
Was wird zusammengeführt?
Lexikalische Suche beruht auf Begriffen; Tokenisierung und Feldkonfiguration beeinflussen das Ergebnis. Muss ein Produktcode exakt stimmen, ist ein eigenes Feld oder ein Filter sinnvoll. Vektorsuche nutzt Ähnlichkeit im Embedding-Raum, kann aber ähnliche Modellnamen oder Verneinungen verwechseln.
Die Rohwerte beider Verfahren haben nicht zwingend dieselbe Skala. Reciprocal Rank Fusion (RRF) addiert stattdessen 1 / (k + r) für jede Liste, in der ein Kandidat vorkommt. Rang r beginnt bei 1, ein fehlender Kandidat trägt nichts bei. Die Formel erläutert die RRF-Dokumentation von Elastic.
Rangfusion ausführen
Speichern Sie den Code als rrf_demo.py und starten Sie python3 rrf_demo.py. Beide Suchverfahren müssen denselben Chunk derselben Dokumentversion über dieselbe ID identifizieren.
from collections import defaultdict


def rrf(rankings, k=60):
    if k <= 0:
        raise ValueError("k must be positive")
    scores = defaultdict(float)
    for ranking in rankings:
        # Count an ID only once per retriever, preserving order.
        unique = list(dict.fromkeys(ranking))
        for rank, chunk_id in enumerate(unique, start=1):
            scores[chunk_id] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda item: (-item[1], item[0]))


keyword = ["manual-A", "manual-B", "manual-C"]
semantic = ["manual-C", "manual-A", "manual-D"]
result = rrf([keyword, semantic])
print([(key, round(score, 6)) for key, score in result])
assert [key for key, _ in result] == ["manual-A", "manual-C", "manual-B", "manual-D"]
assert rrf([["A", "A", "B"]]) == rrf([["A", "B"]])
assert rrf([]) == []
Erwartete Ausgabe:
[('manual-A', 0.032522), ('manual-C', 0.032266), ('manual-B', 0.016129), ('manual-D', 0.015873)]
A und C profitieren davon, in beiden Listen aufzutauchen. Doppelte IDs zählen innerhalb einer Liste nur einmal. Bei Gleichstand entscheidet die ID, damit die Reihenfolge reproduzierbar bleibt. k=60 ist eine Beispielwahl und nicht für jeden Bestand optimal. Der Code kombiniert vorhandene Ranglisten; er implementiert weder einen Suchindex noch Embeddings.
Berechtigungen vor der Suche angleichen
Beide Suchpfade müssen dieselbe Organisation, denselben Dokumentbereich, dieselben Leserechte und Versionen berücksichtigen. Unberechtigte Texte erst an das Modell zu senden und anschließend in der Oberfläche auszublenden, ist keine Zugriffskontrolle. Der Server bestimmt den erlaubten Bereich und wendet ihn auf jede Suche an. Auch beim Öffnen der Quelle werden Rechte geprüft.
Kandidatenzahl und endgültige Kontextgröße sind getrennte Einstellungen. Ein Versuch kann je Verfahren 20 Treffer abrufen und nach der Fusion 5 behalten. Das sind Versuchsbedingungen, keine Produktvorgaben. Messen Sie bei größeren Kandidatenmengen sowohl zusätzlich gefundene Belege als auch die Latenz.
Mit denselben Fragen vergleichen
| Fragetyp | Mögliches Problem | Prüfung |
|---|---|---|
| Exakter Produktcode | Handbuch eines anderen Modells | Codes der ersten Treffer vergleichen |
| Umformulierung | Beleg wegen anderer Wörter verpasst | Richtiger Beleg unter den ersten 5 |
| Nicht beantwortbare Frage | Antwort aus unpassendem Text | Fehlende Belege ausdrücklich benennen |
| Geschütztes Dokument | Inhalt einer anderen Gruppe | Keine unberechtigten Texte weiterreichen |
Legen Sie Fragen und erwartete Belege fest, bevor Sie lexikalische, semantische und kombinierte Suche vergleichen. Eine Kennzahl ist der Anteil der Fragen mit mindestens einem richtigen Beleg unter den ersten 5 Treffern. Verbesserungen dürfen erst nach eigener Messung behauptet werden. Ein RRF-Wert ist keine Wahrscheinlichkeit für eine richtige Antwort. Reranking findet keine Belege, die schon in den Kandidaten fehlen.
Verliert ein Treffer an seiner Grenze den Zusammenhang, prüfen Sie zuerst Chunking und Quellenpositionen. Den Gesamtprozess erläutert der Weg vom Dokument zur Antwort.