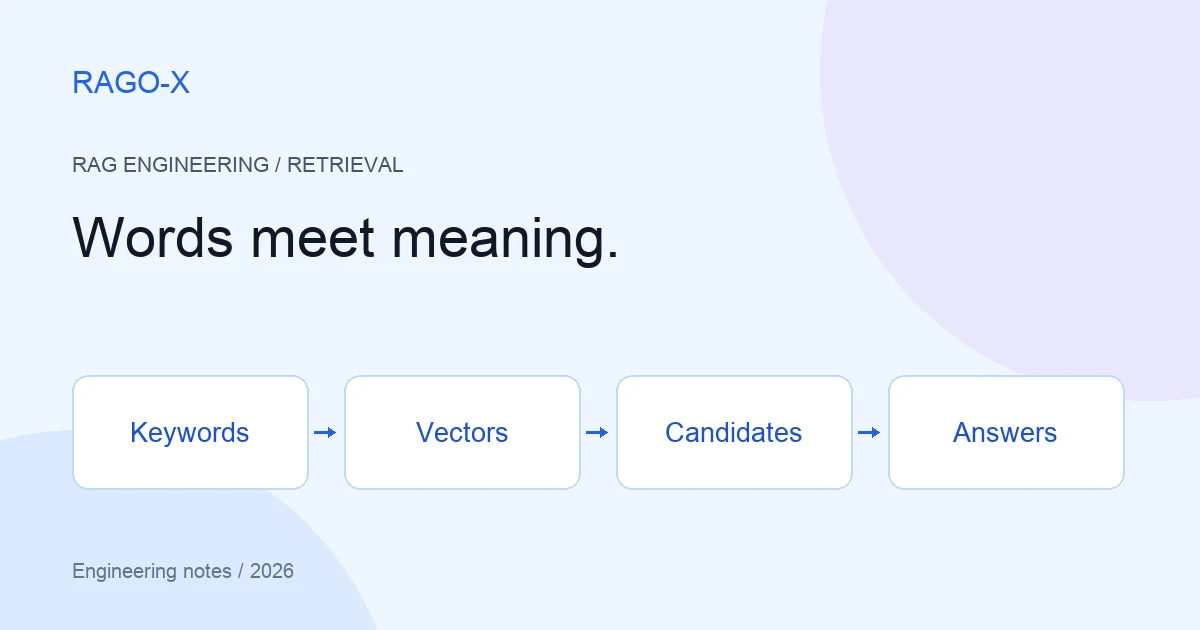
문서 검색에서 “X17 필터 교체”와 “흡입 압력이 떨어질 때 무엇을 확인하나요?”는 같은 매뉴얼을 요구할 수 있습니다. 첫 질문은 제품 코드가 중요하고, 두 번째는 문서와 표현이 달라도 의미가 맞아야 합니다. 하이브리드 검색은 서로 다른 검색 방식의 후보를 모아 이 두 요구를 함께 다루는 설계입니다.
이 글에서는 검색 엔진을 설치하지 않고 Python 3 표준 라이브러리만으로 순위 결합을 재현합니다. 아래 후보와 질문은 설명을 위한 가상 데이터이며, RAGO-X의 운영 검색 설정이나 측정 성능을 나타내지 않습니다.
어떤 검색 결과를 결합하나요?
키워드 검색은 용어 일치에 기반하며, 실제 동작은 토큰화·형태소 분석·필드 설정의 영향을 받습니다. 제품 코드가 반드시 일치해야 한다면 분석된 본문 검색만 믿기보다 별도 코드 필드나 필터가 필요합니다. 벡터 검색은 임베딩 공간의 유사도로 후보를 찾지만, 비슷한 이름의 다른 제품이나 부정문을 혼동할 수 있습니다.
두 검색기의 점수를 그대로 더하면 점수 범위가 큰 쪽이 지배할 수 있습니다. 여기서는 점수 대신 순위를 사용하는 RRF(Reciprocal Rank Fusion)를 사용합니다. 각 목록에서 후보의 순위가 r이면 1 / (k + r)를 더합니다. 순위는 1부터 시작하며, 목록에 없는 후보의 기여는 0입니다. Elastic의 RRF 설명에서 수식을 확인할 수 있습니다.
직접 실행하는 순위 결합
아래를 rrf_demo.py에 저장하고 python3 rrf_demo.py로 실행하세요. 같은 문서 버전의 동일 청크가 검색기마다 같은 ID를 사용해야 결합할 수 있습니다.
from collections import defaultdict


def rrf(rankings, k=60):
    if k <= 0:
        raise ValueError("k must be positive")
    scores = defaultdict(float)
    for ranking in rankings:
        # Count an ID only once per retriever, preserving order.
        unique = list(dict.fromkeys(ranking))
        for rank, chunk_id in enumerate(unique, start=1):
            scores[chunk_id] += 1.0 / (k + rank)
    return sorted(scores.items(), key=lambda item: (-item[1], item[0]))


keyword = ["manual-A", "manual-B", "manual-C"]
semantic = ["manual-C", "manual-A", "manual-D"]
result = rrf([keyword, semantic])
print([(key, round(score, 6)) for key, score in result])
assert [key for key, _ in result] == ["manual-A", "manual-C", "manual-B", "manual-D"]
assert rrf([["A", "A", "B"]]) == rrf([["A", "B"]])
assert rrf([]) == []
출력은 다음과 같습니다.
[('manual-A', 0.032522), ('manual-C', 0.032266), ('manual-B', 0.016129), ('manual-D', 0.015873)]
A와 C는 두 목록에 모두 등장해서 우선순위가 올라갑니다. 한 목록 안의 중복 ID는 한 번만 계산하고, 동점은 ID 순으로 정렬해 재실행 결과를 일정하게 유지했습니다. k=60은 이 예제의 선택이며 모든 데이터에 최적인 값은 아닙니다. 이 코드는 이미 만들어진 순위를 결합할 뿐, 임베딩이나 키워드 검색 자체를 수행하지 않습니다.
권한과 후보 수를 먼저 맞추기
두 검색 경로 모두 같은 조직·문서함·열람 권한·문서 버전 범위를 적용해야 합니다. 권한 밖의 본문을 가져와 모델에 전달한 뒤 화면에서만 숨기는 방식은 접근 통제가 아닙니다. 실제 시스템에서는 서버에서 허용 범위를 결정하고 각 검색에 적용하며, 출처를 열 때도 권한을 확인해야 합니다.
검색기별 후보 수와 최종 전달 수는 다른 설정입니다. 예를 들어 각각 20개를 찾고 결합 후 5개를 선택하는 실험을 할 수 있습니다. 후보 수를 늘릴 때는 관련 근거가 더 발견되는지와 지연 시간을 함께 측정하세요. 이 수치는 실험 조건의 예시이지 권장 기본값이 아닙니다.
같은 질문으로 비교하기
| 질문 유형 | 확인할 실패 | 평가 방법 |
|---|---|---|
| 정확한 제품 코드 | 다른 모델의 매뉴얼 선택 | 상위 후보의 코드 일치 여부 |
| 표현을 바꾼 질문 | 용어가 달라 근거 누락 | 정답 근거가 상위 5개에 있는지 |
| 문서에 없는 질문 | 무관한 후보로 답변 생성 | 근거 부족을 알리는지 |
| 권한 제한 문서 | 다른 그룹의 근거 노출 | 제한된 후보·본문이 전달되지 않는지 |
질문과 정답 근거를 먼저 고정하고 키워드만, 벡터만, 결합 검색을 비교하세요. 적어도 하나의 정답 근거가 상위 5개에 포함된 질문의 비율을 측정할 수 있습니다. 실제 데이터 없이 “정확도 향상” 수치를 주장하지 마세요. RRF 점수는 정답 확률이 아니며, 재순위화도 최초 검색에서 빠진 근거를 되살릴 수는 없습니다.
검색 결과가 잘려 의미를 잃는다면 결합 방식을 바꾸기 전에 청크 경계와 원문 위치를 확인하세요. 전체 처리 흐름은 문서에서 근거 있는 답변까지에서 이어집니다.